GPT-6.1 Sol 공개, Astra에 가까운 성능을 5분의 1 가격에
OpenAI가 GPT-6.1 Sol을 공개했다. 코딩·문서 작업·컴퓨터 사용 평가에서 Astra에 근접한 성능을 보이며, 표준 API 입력·출력 토큰 가격은 Astra의 5분의 1이다.
OpenAI가 GPT-6 Sol의 업그레이드 모델인 GPT-6.1 Sol을 공개했다. 회사는 코딩, 전문 문서 작업, 컴퓨터 사용 등 여러 평가에서 GPT-6 Astra에 가까운 성능을 보이면서 표준 API 입력·출력 토큰 가격은 Astra의 5분의 1이라고 설명한다. GPT-6.1 Sol의 강점은 높은 성능을 더 낮은 비용으로 쓸 수 있다는 데 있다.
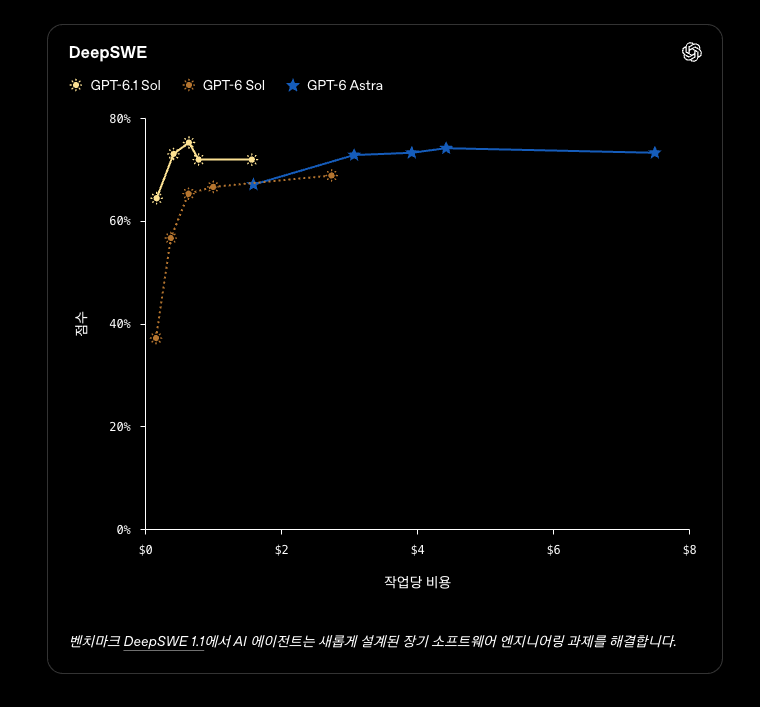
코딩과 문서 작업에서 Astra와의 격차를 좁혔다
실제 코드베이스의 장기 소프트웨어 개발 과제를 푸는 DeepSWE 1.1에서 GPT-6.1 Sol은 약 5분의 1 작업 비용으로 GPT-6 Astra와 대등한 성능을 보였다. GPT-6 Sol의 최고 점수도 더 낮은 추론 강도와 비용으로 6.4%포인트 웃돌았다.
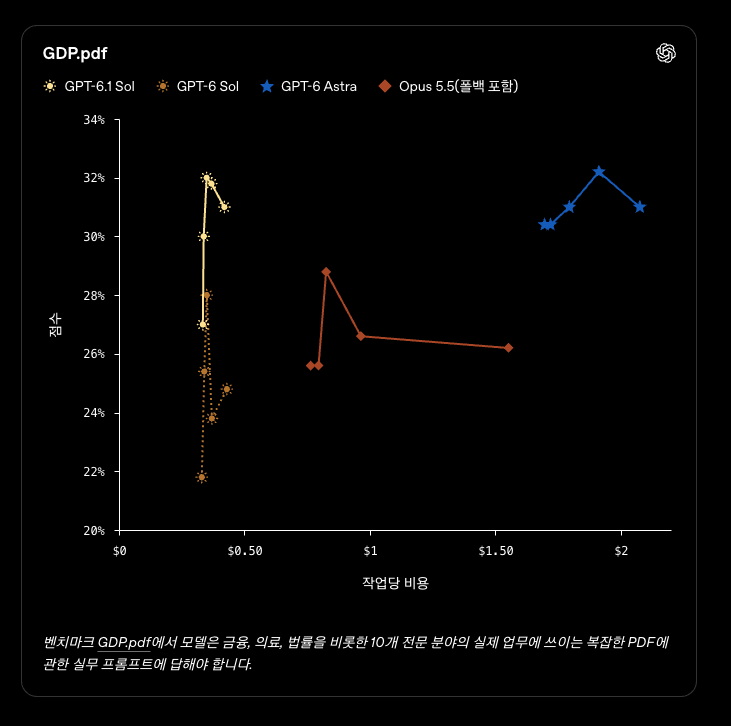
복잡한 PDF 문서를 읽고 전문적인 질문에 답하는 GDP.pdf 평가에서도 GPT-6.1 Sol은 Astra의 점수에 근접했다. OpenAI에 따르면 테스트한 추론 설정에서 폴백을 사용하는 Opus 5.5보다 높은 점수를 기록했고, 작업당 비용은 절반 미만이었다. 여러 도구를 거치는 업무를 평가하는 AutomationBench에서는 중간 추론 강도 기준 GPT-6 Sol보다 4.8%포인트 높은 점수를 냈다.
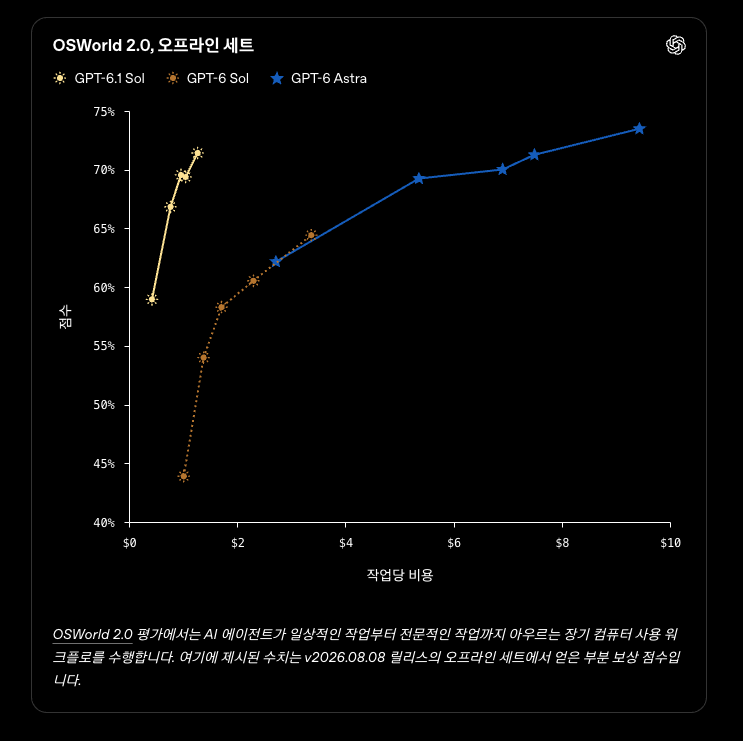
컴퓨터 사용과 과학 작업에서도 개선됐다
컴퓨터 애플리케이션을 조작하는 장기 작업을 평가한 OSWorld 2.0의 오프라인 세트에서 GPT-6.1 Sol은 최대 추론 강도 기준 GPT-6 Sol보다 7%포인트 높은 점수를 기록했다. 작업당 비용은 절반 미만이었다. 같은 설정의 Astra와는 2.1%포인트 차이였고, 작업당 비용은 약 7분의 1이었다.
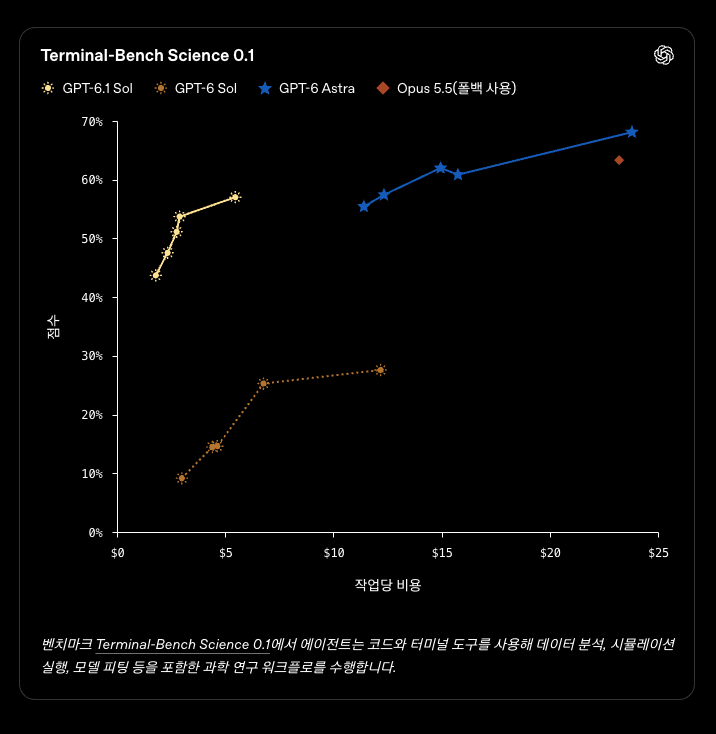
데이터 분석과 시뮬레이션 등을 평가하는 Terminal-Bench Science 0.1에서는 최대 추론 강도에서 GPT-6 Sol 점수의 2배 이상을 기록했다. 이때 GPT-6.1 Sol의 평균 작업당 비용은 5.47달러로, Astra의 23.80달러보다 낮았다. 다만 이 평가에서 최고 점수는 Astra의 68.1%였다.
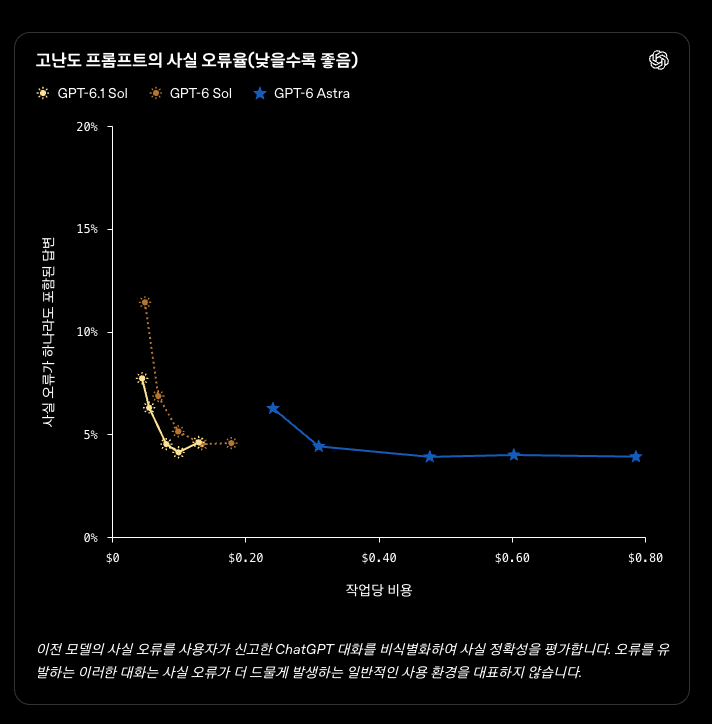
고난도 질문에 대한 사실 오류율도 낮아졌다. OpenAI가 공개한 평가에서 최대 추론 강도 기준 GPT-6.1 Sol의 오류율은 4.1%, GPT-6 Sol은 4.5%, Astra는 4.0%였다. 이 평가는 오류를 유발하도록 고른 대화를 사용하므로 일반적인 사용 환경의 오류율로 해석할 수 없다.
API 가격과 이용 범위
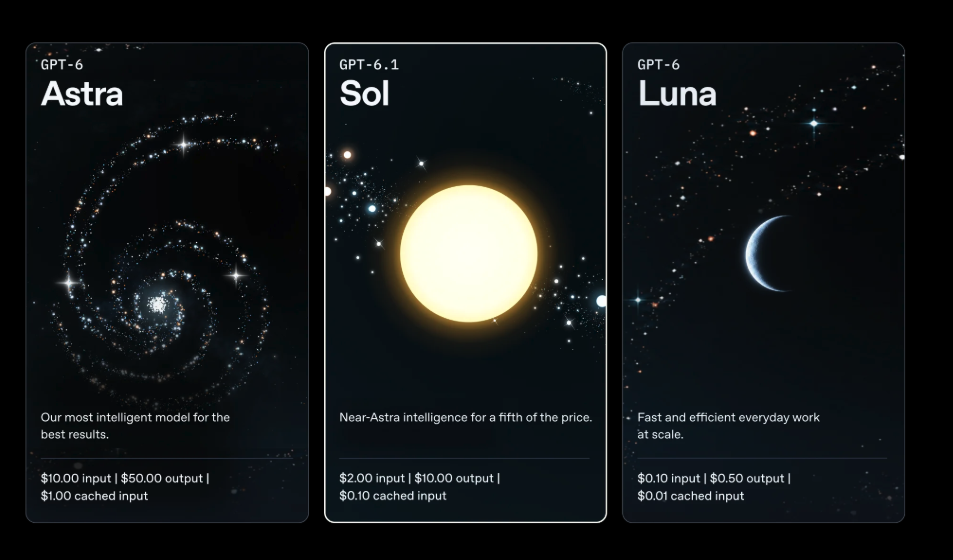
GPT-6.1 Sol의 표준 API 가격은 입력 토큰 100만 개당 2달러, 출력 토큰 100만 개당 10달러다. 캐시된 입력은 100만 토큰당 0.10달러다. 표준 입력·출력 토큰 가격을 기준으로 하면 Astra의 5분의 1이다. 앞서 언급한 벤치마크의 ‘작업당 비용’은 각 평가에서 실제 과제를 수행하는 데 든 비용으로, 토큰 단가와 구분해야 한다.
OpenAI 발표 시점 기준 Plus, Pro, Business, Enterprise, Edu 사용자는 ChatGPT Work와 Codex에서 GPT-6.1 Sol을 이용할 수 있다. API 모델명은 gpt-6.1-sol이다. 일반 Chat에서는 아직 제공되지 않는다고 OpenAI는 밝혔다.
어떤 선택에 적합한가
GPT-6.1 Sol은 코딩 에이전트, 복잡한 문서 처리, 컴퓨터 작업을 자주 실행하면서 비용도 관리해야 하는 경우에 눈여겨볼 모델이다. 공개된 평가는 OpenAI의 연구 환경이나 API에서 이뤄졌으며 실제 서비스에서는 도구와 추론 설정에 따라 결과가 달라질 수 있다. 중요한 작업은 실제 입력과 예산으로 시험한 뒤 모델을 선택하는 편이 정확하다.
출처
팩트 체크 기준일: 2026년 9월 30일